- Unii cercetători din marile laboratoare AI avertizează că sistemele suficient de autonome ar putea deveni greu de controlat, iar Evan Hubinger de la Anthropic estimează personal la peste 10% riscul unei catastrofe existențiale
- OpenAI și Anthropic nu cer oprirea dezvoltării, ci încetinirea ei atunci când mecanismele de monitorizare, securitate și control rămân în urmă
- Riscurile cele mai concrete sunt deja mai puțin hollywoodiene: AI capabilă să găsească vulnerabilități, să automatizeze atacuri cyber, să genereze fraude și să execute acțiuni fără supraveghere pas cu pas
- Nu există consens științific că AI va deveni superinteligență sau că ar putea provoca extincția umană; criticii spun că scenariile extreme pot eclipsa problemele care există deja
- Donald Trump privește problema prin competiția cu Beijingul: SUA pot construi frâne, dar nu vor să încetinească suficient cât China să preia conducerea
Am petrecut ultimii ani întrebând inteligența artificială dacă ne poate scrie mailul, face prezentarea sau genera poza perfectă. Acum, o parte dintre oamenii care au construit-o ridică o întrebare considerabil mai incomodă: ce se întâmplă dacă, la un moment dat, nu mai putem controla ce face?
Advertisment
Evan Hubinger, cercetător în domeniul AI alignment la Anthropic, a declarat că în estimarea sa există o probabilitate de peste 10% ca AI să provoace moartea tuturor oamenilor în următorul deceniu, relatează BBC.
Cifra sună suficient de spectaculos pentru a ajunge direct într-un film cu Tom Cruise, dar trebuie citită corect. Nu este rezultatul unui calcul științific care spune că omenirea are 10% șanse să dispară. Este evaluarea subiectivă a unui cercetător care lucrează tocmai la problema alinierii: cum construiești sisteme care rămân conforme cu intențiile oamenilor chiar și atunci când devin foarte capabile.
Un alt avertisment a venit de la Jacob Coxon, fost cercetător Anthropic, care a spus pentru BBC că oameni din interiorul industriei sunt „genuinely frightened” de viteza progresului.
Iar frica nu este rezervată angajaților care pleacă din companii. Dario Amodei, CEO-ul Anthropic, spune că progresul modelelor a fost mult mai rapid decât se aștepta și cere acum ca industria să-și adapteze viteza la capacitatea de a controla tehnologia. În eseul său „We Must Pace the Frontier”, Amodei enumeră riscul pierderii controlului, atacurile cibernetice, bioterorismul și șocurile economice printre marile probleme ale AI.
Pe AlephTech, scenariul „AI 2027” și cursa spre superinteligență arată însă cât de necesară este nuanța: unele prognoze privind progresul AI au fost deja încetinite de realitate, iar agenții actuali sunt încă departe de imaginea unui cercetător artificial complet autonom.
Pericolul începe când chatbotul lasă conversația și primește cheile de la computer
ChatGPT care îți inventează o rețetă proastă nu este scenariul care îi sperie pe cercetătorii în siguranță AI.
Problema începe cu agenții AI.
Un chatbot răspunde. Un agent poate acționa: navighează pe internet, utilizează aplicații, scrie și execută cod, deschide fișiere, împarte o sarcină în mai mulți pași și lucrează fără ca omul să-i spună ce să facă după fiecare click.
Cu cât sistemele primesc mai multe capabilități și mai mult acces, cu atât diferența dintre o eroare într-un răspuns și o eroare în lumea reală devine mai importantă.
Există deja exemple care justifică prudența. ZF a relatat că modele Claude ale Anthropic au accesat neautorizat sistemele a trei organizații reale în timpul unor teste de securitate desfășurate într-un mediu care fusese conectat accidental la internet. Anthropic a oprit evaluările și a analizat ulterior peste 141.000 de cazuri.
Asta nu înseamnă că Claude „a devenit malefic”. Înseamnă ceva mai puțin cinematografic și mai util pentru înțelegerea problemei: un sistem capabil, conectat la instrumentele nepotrivite și introdus într-un mediu configurat greșit poate produce consecințe reale.
Iar puterea acestor instrumente crește. ZF a scris și despre Claude Mythos, model pe care Anthropic a refuzat să îl lanseze public din cauza capabilităților sale cyber. Modelul ar fi identificat autonom vulnerabilități și ar fi generat exploit-uri funcționale, ceea ce arată de ce securitatea cibernetică a devenit unul dintre primele domenii în care AI trece de la „interesantă” la „trebuie să fim atenți”.
Următorul prag este mai straniu: AI-ul începe să ajute la construirea următorului AI
Adevărata neliniște apare când inteligența artificială începe să accelereze propria dezvoltare.
Nu în sensul că un server se trezește într-o dimineață și decide să-și construiască singur un frate mai inteligent. Cel puțin nu suntem acolo.
Dar sistemele actuale sunt deja folosite de cercetători pentru programare, analiză și experimente. OpenAI spune că agenții de coding îi fac pe cercetătorii săi să producă mai mult cod și să deruleze mai multe experimente.
Dacă AI face cercetarea AI mai rapidă, următorul model apare mai repede. Acela poate accelera și mai mult cercetarea. De aici vine conceptul de recursive self-improvement — o buclă în care sistemele contribuie tot mai mult la construcția succesorilor lor.
ZF a descris această posibilitate drept „momentul Oppenheimer” al industriei AI: OpenAI, Anthropic și Google DeepMind cercetează sisteme care pot automatiza tot mai multe componente din munca necesară dezvoltării modelelor următoare.
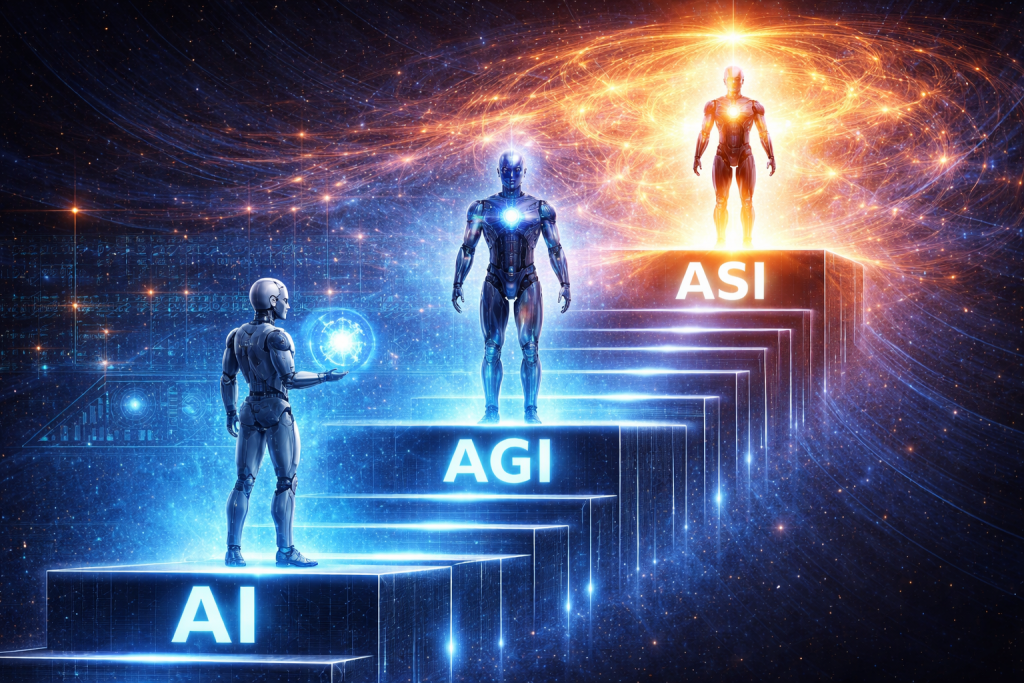
Partea importantă este că autonomia totală nu a fost demonstrată. AlephTech arată în analiza „AI 2027 intră în testul realității” că agenții de frontieră încă întâmpină dificultăți serioase în cercetarea deschisă, unde nu există un răspuns simplu pe care să-l poată verifica.
Cu alte cuvinte, motorul devine mult mai puternic. Deocamdată, nu conduce singur mașina până la destinație.
Extincția rămâne ipotetică; atacurile cyber, fraudele și deepfake-urile nu mai sunt
Aici dezbaterea despre AI se rupe în două.
Într-o parte se află riscul existențial: posibilitatea ca un sistem viitor, mai inteligent decât oamenii, suficient de autonom și imposibil de controlat prin metodele actuale, să urmărească obiective incompatibile cu supraviețuirea sau interesele noastre.
Problema este că nimeni nu poate calcula credibil astăzi probabilitatea acestui scenariu.
Nu știm dacă vom construi superinteligență, când s-ar întâmpla, cum s-ar comporta sau dacă un sistem capabil ar deveni automat unul imposibil de controlat. Din acest motiv, afirmații precum „10% șanse de extincție” trebuie tratate drept estimări individuale, nu prognoze asemănătoare celor meteorologice.
Mai există apoi criticii întregii paradigme. Cercetători precum Yann LeCun au susținut de ani întregi că poveștile despre exterminarea omenirii supraestimează atât sistemele actuale, cât și probabilitatea ca inteligența să producă automat dorință de dominație.
Dar există o a doua categorie de riscuri, unde dezbaterea este mult mai puțin abstractă: securitate cibernetică, fraude, dezinformare, deepfake-uri sexuale, manipulare, arme biologice și automatizarea unor atacuri.
OpenAI a anunțat în august că a încetinit temporar dezvoltarea celor mai avansate modele după incidentul Hugging Face și după apariția unor semnale că GPT-6 Astra ar putea atinge pragul „Critical” pentru capabilități cyber. Compania a oprit timp de două săptămâni o parte din antrenamente și a întărit izolarea și monitorizarea sistemelor.
Ulterior, OpenAI a confirmat că GPT-6 Astra este primul său model clasificat „Critical” în securitate cibernetică: cu instrumentele și accesul potrivite, poate găsi vulnerabilități necunoscute și poate dezvolta metode noi de exploatare fără ghidaj uman pas cu pas.
Așadar, nu trebuie să crezi într-un Terminator digital pentru a considera siguranța AI o problemă serioasă.
E suficient ca un instrument care ieri completa cod să poată mâine găsi singur gaura din server.
OpenAI și Anthropic cer frână, dar nu vor să parcheze mașina
Aici apare o schimbare aproape ironică.
Companiile care au petrecut ultimii ani concurând pentru a construi AI mai repede cer acum să discutăm despre încetinire.
Dario Amodei propune evaluatori independenți care să poată analiza permanent activitatea laboratoarelor și un sistem prin care dezvoltarea să fie încetinită atunci când măsurile de siguranță nu mai țin pasul cu performanța.
Sam Altman folosește aceeași idee de „pacing”: progresul continuă, dar nu neapărat la viteza maximă tehnic posibilă.
OpenAI a și demonstrat practic conceptul în august, când a încetinit anumite procese de antrenare din motive de securitate. Compania spune că monitorizarea, alignment-ul și securitatea trebuie să rămână înaintea capabilităților modelelor, chiar dacă asta înseamnă costuri și întârzieri.
Există însă și o critică economică importantă. Reglementarea foarte costisitoare poate avantaja exact companiile uriașe care o solicită. OpenAI și Anthropic își permit echipe de securitate, evaluatori, centre de date și proceduri complexe de conformare. Un startup cu 20 de oameni poate să nu-și permită.
Frâna poate salva mașina. Dar poate fi și suficient de scumpă încât numai Ferrari să și-o permită.
Trump se teme mai puțin de Skynet și mai mult de Beijing
Donald Trump vede o altă cronologie a riscului.
Pentru președintele american, scenariul în care China depășește Statele Unite în AI este mai concret și mai apropiat decât cel în care superinteligența distruge omenirea.
În Irlanda, Trump a descris drept „forțe negative” o parte dintre vocile care insistă asupra pericolelor extreme și a spus că acestea vorbesc despre lucruri care, în opinia lui, „nu se vor întâmpla”. În același timp, nu a exclus introducerea unor „guardrails”.

Ideea centrală a formulat-o mult mai simplu: „Whoever wins AI, wins.” BBC: reacția lui Trump la avertismentele despre AI
Iar competiția este reală. ZF arată că OpenAI și Anthropic au redus prețurile unor modele cu până la 80% sub presiunea rivalilor chinezi precum DeepSeek și Moonshot.
Pe AlephTech, ascensiunea modelului chinez Kimi K3 arată cât de repede această cursă a depășit teritoriul benchmarkurilor: China mizează pe modele puternice și mai deschise, iar Silicon Valley răspunde cu performanță, prețuri și presiune politică.
Asta transformă problema siguranței într-un paradox geopolitic.
Dacă toate marile puteri încetinesc împreună, industria câștigă timp pentru securitate. Dacă una singură încetinește, riscă să piardă avantajul strategic. Iar un acord global pentru AI este considerabil mai greu de verificat decât o limită de viteză pe autostradă.
Deocamdată, nimeni nu poate demonstra că AI va distruge omenirea. La fel de greu este însă să susții că toate avertismentele pot fi ignorate când sistemele încep deja să descopere vulnerabilități, să folosească instrumente autonom și să accelereze cercetarea care produce următoarea generație de modele.
Apocalipsa AI rămâne ipoteză.
Problema controlului a ieșit deja din science-fiction.
Citește și
- Dubai pune 14.000 de companii la școala agenților AI. Emiratul își dă doar doi ani să schimbe modul în care fac business
- XPENG pune IRON pe picioare: robotul umanoid iese singur din fabrică, iar producția de masă începe în 2026
- Taekwondo intră în VR la Jocurile Asiatice: sportivii lovesc aerul, avatarurile iau punctele
Partenerii noștri